一个skill从能用到可维护,到底差了什么?——yao-meta-skill给我的五个认知转变
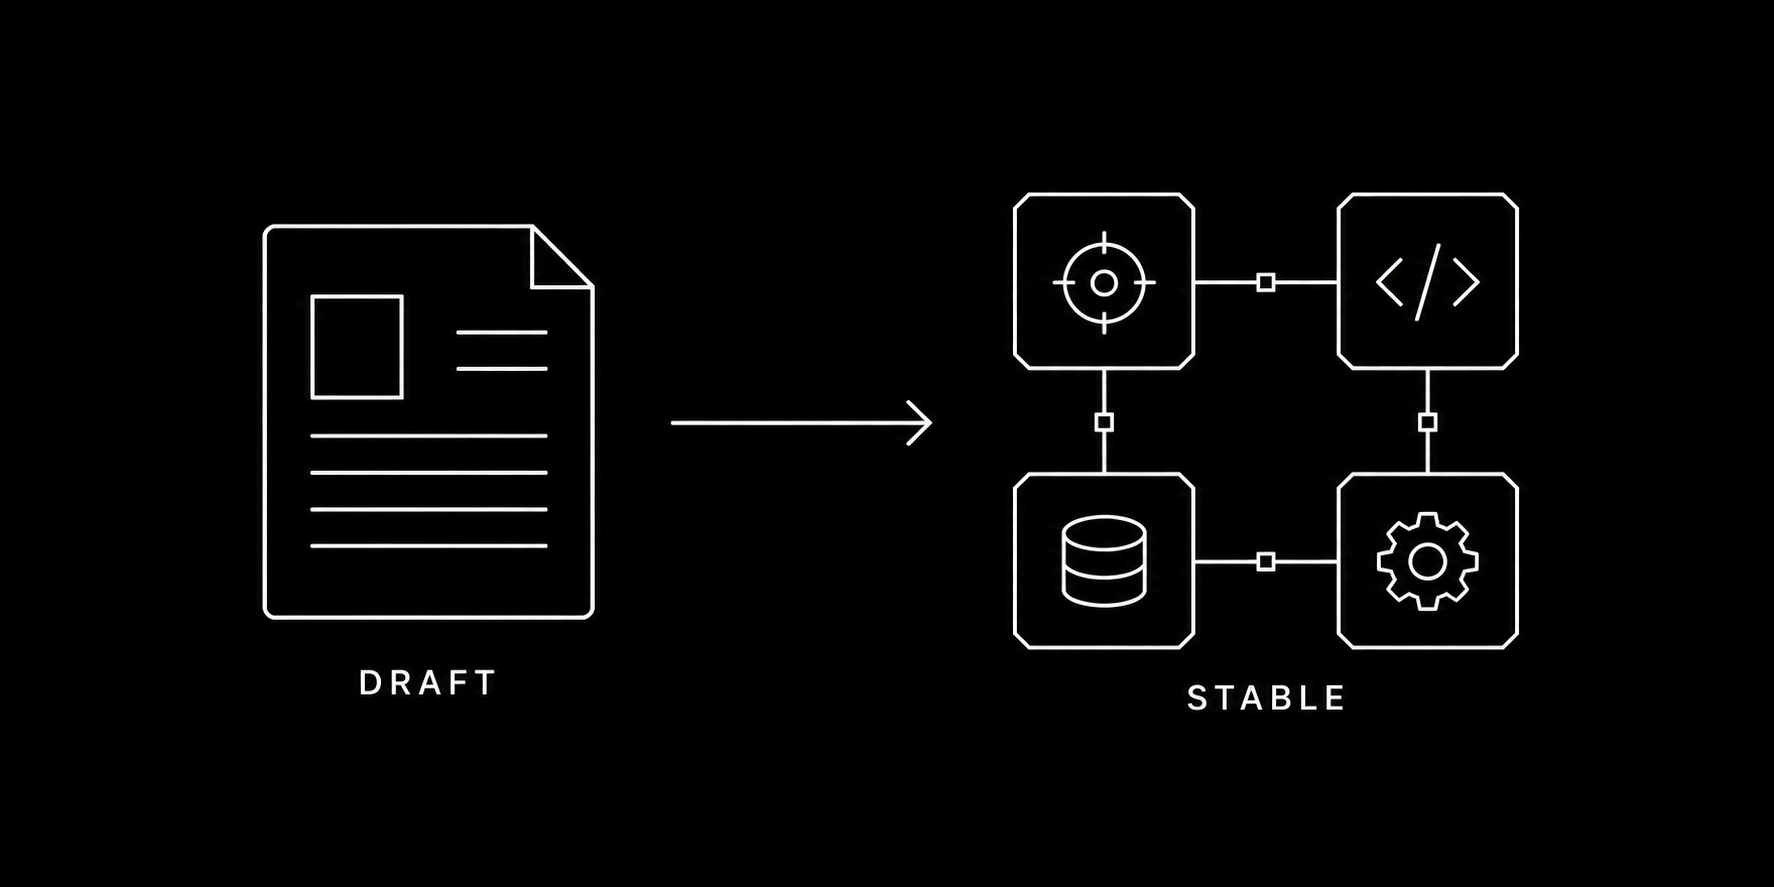
最近我花了一些时间研究 yao-meta-skill。
在这之前,我已经用过 Codex 或 Claude 里的内置 skill creator。
那类内置工具很好用。它们适合快速把一个想法变成第一版 skill:你描述一下场景,补几句边界,AI 帮你生成一个 SKILL.md。如果只是个人使用、轻量复用,体验其实已经很顺了。
所以我一开始看 yao-meta-skill 时,心里其实有个疑问:
既然 Codex 和 Claude 已经有内置的 skill 创建能力,为什么还需要一个独立的 yao-meta-skill?
但真正读完它的 README、中文文档、references、evals 和 reports 之后,我发现这里的差异不是“谁更会写说明”,而是定位完全不同。
yao-meta-skill 真正有意思的地方,不是“自动生成 skill”,而是它把一件更底层的事情工程化了:
如何把一个人脑子里的隐性经验,变成 agent 可以稳定触发、执行、评估、打包、治理的能力包。
这件事看起来像是 skill 编写方法的延伸,但我越看越觉得,它其实是在把我们从 skill writing 推向 skill engineering。
也正是从这个角度,我开始理解它和内置 skill creator 的差异:内置工具更像“帮我做出一个 skill”,而 yao-meta-skill 更像“帮我建立一套生产、评测和维护 skill 的工程系统”。
一、差异不是从生成开始,而是从第一版之后开始
如果读者已经写过 skill,就会知道:生成第一版并不难。
真正麻烦的是第一版之后。
一个 skill 看起来已经能跑了,但你很快会遇到几个更细的问题:
description到底够不够准,还是只是这次刚好被触发了;SKILL.md继续加规则时,会不会从执行骨架膨胀成说明书;- 相邻场景出现时,agent 是会正确避开,还是会过度热心地抢任务;
- workflow 里哪些内容应该留在入口文件,哪些应该拆到
references/、scripts/、evals/; - 如果这个 skill 要给别人用,你拿什么证明它没有误触发、漏触发或悄悄变差;
- 当它变成团队资产,谁负责维护,什么时候 review,什么变化需要重新跑评测。
内置 skill creator 的强项,是把一个想法快速变成可用的第一版。它降低了创作门槛,适合探索,也适合个人场景里的轻量复用。
yao-meta-skill 的差异化,不在于它能不能也生成第一版,而在于它把“第一版之后的工程问题”摆到了台前。
我更愿意把它理解成一条加固链路:
first draft -> boundary design -> trigger eval -> resource split -> quality gates -> governance -> packaging这条链路背后的问题不是“怎么写一个 skill”,而是:
一个 skill 如何从能用,变成可复用、可评估、可维护、可分发。
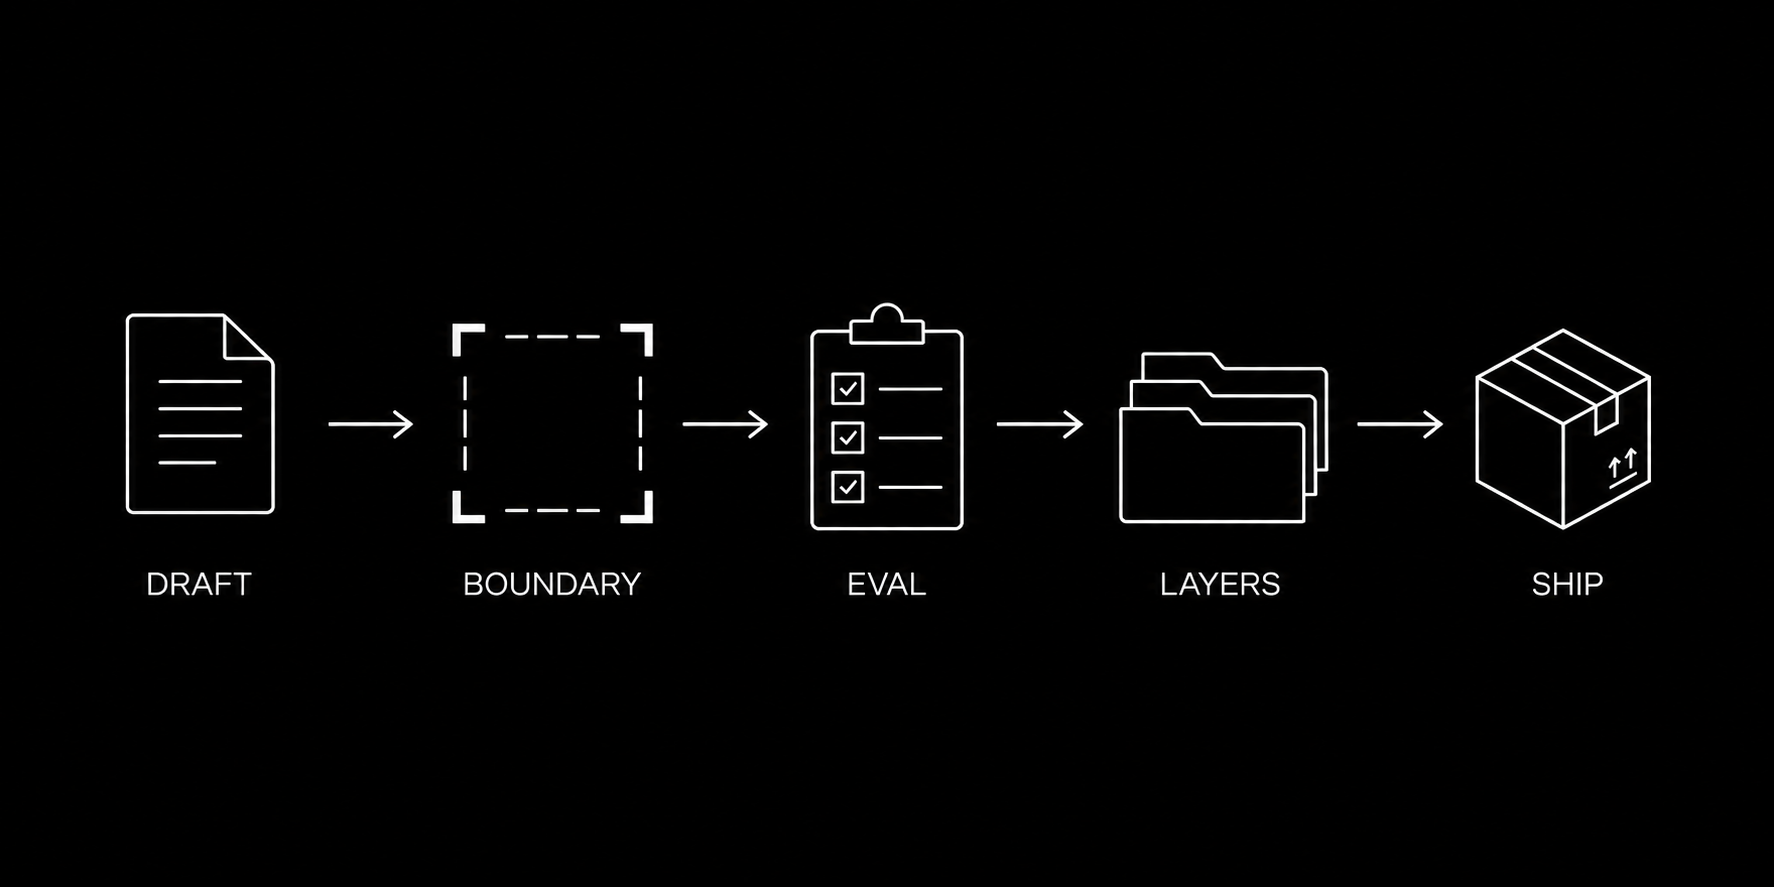
这个角度一换,yao-meta-skill 的价值就清楚了。它不是一个更大的模板,也不是一份更长的写作指南,而是一套面向 skill 生命周期的工程方法。
我现在会这样区分两类工具:
| 维度 | 内置 skill creator | yao-meta-skill |
|---|---|---|
| 核心价值 | 快速起草第一版 | 加固整个生命周期 |
| 关注重点 | 写得出来、能跑起来 | 触发准、边界清、可回归 |
| 质量证明 | 主要靠人工感觉和试用 | 靠 eval、reports、gates 和 history |
| 复杂性处理 | 多数内容留在入口说明里 | 拆到 references、scripts、evals、reports |
| 适用阶段 | 探索、个人复用、快速成型 | 团队复用、长期维护、跨平台分发 |
二、第一个认知转变:skill 不是说明书,而是可路由的能力包
很多第一版 skill,最后都会自然地长成说明书。
这很正常。我们习惯了写文档:背景是什么、适用场景是什么、步骤是什么、注意事项是什么、示例是什么。写着写着,SKILL.md 就变成了一篇长文。
但 yao-meta-skill 的设计恰恰反过来。
它要求 SKILL.md 保持克制。主入口只放几类真正必要的信息:
- 这个 skill 什么时候应该被触发;
- 它要接住什么重复任务;
- 它大致怎么执行;
- 它应该交付什么结果;
- 哪些细节应该放到
references/、scripts/、evals/或reports/。
这背后有一个很重要的判断:
agent 不是人类文档读者。它首先需要知道“这个场景该不该叫我”,其次才是“叫我之后怎么做”。
所以一个好 skill 的入口,不应该像百科词条,而应该更像一个清晰的路由接口。
这也是为什么 yao-meta-skill 非常强调 frontmatter 里的 description。它不是一句营销简介,而是 agent 的触发表面。描述写得太宽,就会误触发;写得太窄,就会漏触发;写得太抽象,agent 就分不清它和相邻 skill 的边界。
我觉得这是学习它最重要的第一个转变:
不要先问“我要在 skill 里写多少内容”,先问“agent 在什么情况下应该想起它”。
三、第二个认知转变:先定义边界,再扩写流程
yao-meta-skill 的方法论里,有一个我很喜欢的顺序:先做 intent dialogue。
也就是在真正动手写 skill 之前,先弄清楚几个问题:
- 这个 skill 要长期接住哪一类重复工作?
- 用户真实会给它什么输入?
- 它完成后应该交回什么输出?
- 哪些相近请求不应该由它处理?
- 这件事更在意速度、一致性、可审计性、可移植性,还是风格贴合?
这看起来像需求澄清,但其实更像边界设计。
尤其是“哪些相近请求不应该由它处理”这一点,我以前低估了。
我们做工具时,总想让它更强、更全、更通用。可是 skill 的质量很多时候不是由“它能做多少”决定的,而是由“它知道自己不该做什么”决定的。
比如你要做一个“前端 review skill”,它应该审查可访问性、状态缺失、交互风险和 UI 回归。但它不应该自动变成“帮我重构整个前端架构”的 skill,也不应该变成“帮我设计一个全新产品页面”的 skill。
边界一旦模糊,后面所有事情都会变得昂贵:
description会变宽;- eval case 会混乱;
- references 会越堆越多;
- scripts 会承担不该承担的逻辑;
- 用户也会开始用它做一堆本不属于它的事情。
所以 yao-meta-skill 不是先鼓励你“把流程写完整”,而是先逼你回答:
这个 skill 到底拥有哪一块工作?
这个问题回答不好,写再多正文都只是在堆复杂度。
四、第三个认知转变:可复用工作流不是文件,而是结构
有了 skill 编写经验之后,我们很容易把质量理解成“入口文件写得够不够清楚”。
这当然重要。但在 yao-meta-skill 的语境里,一个 skill 的质量不只来自 SKILL.md 本身,还来自它有没有把不同类型的复杂性放到正确位置。
真正可复用的工作流,还需要更多工程化层次:
references/:放长方法论、领域规则、rubric、模板;scripts/:放确定性、重复性、容易写错的逻辑;evals/:放触发评测、质量评测和回归 case;reports/:放意图分析、风险画像、设计取舍、迭代方向;agents/interface.yaml:放中性的元数据,避免被某一家客户端绑定;manifest.json:放生命周期、治理、成熟度、兼容性等信息。
这套结构有一个朴素但很高级的原则:
不要让 SKILL.md 承担所有复杂性。
如果一段内容只是背景知识,就放到 references。
如果一段逻辑每次都要精确执行,就放到 scripts。
如果一个质量声明需要被反复验证,就放到 evals。
如果一个判断是给 reviewer 看的证据,就放到 reports。
SKILL.md 应该像驾驶舱,而不是仓库。
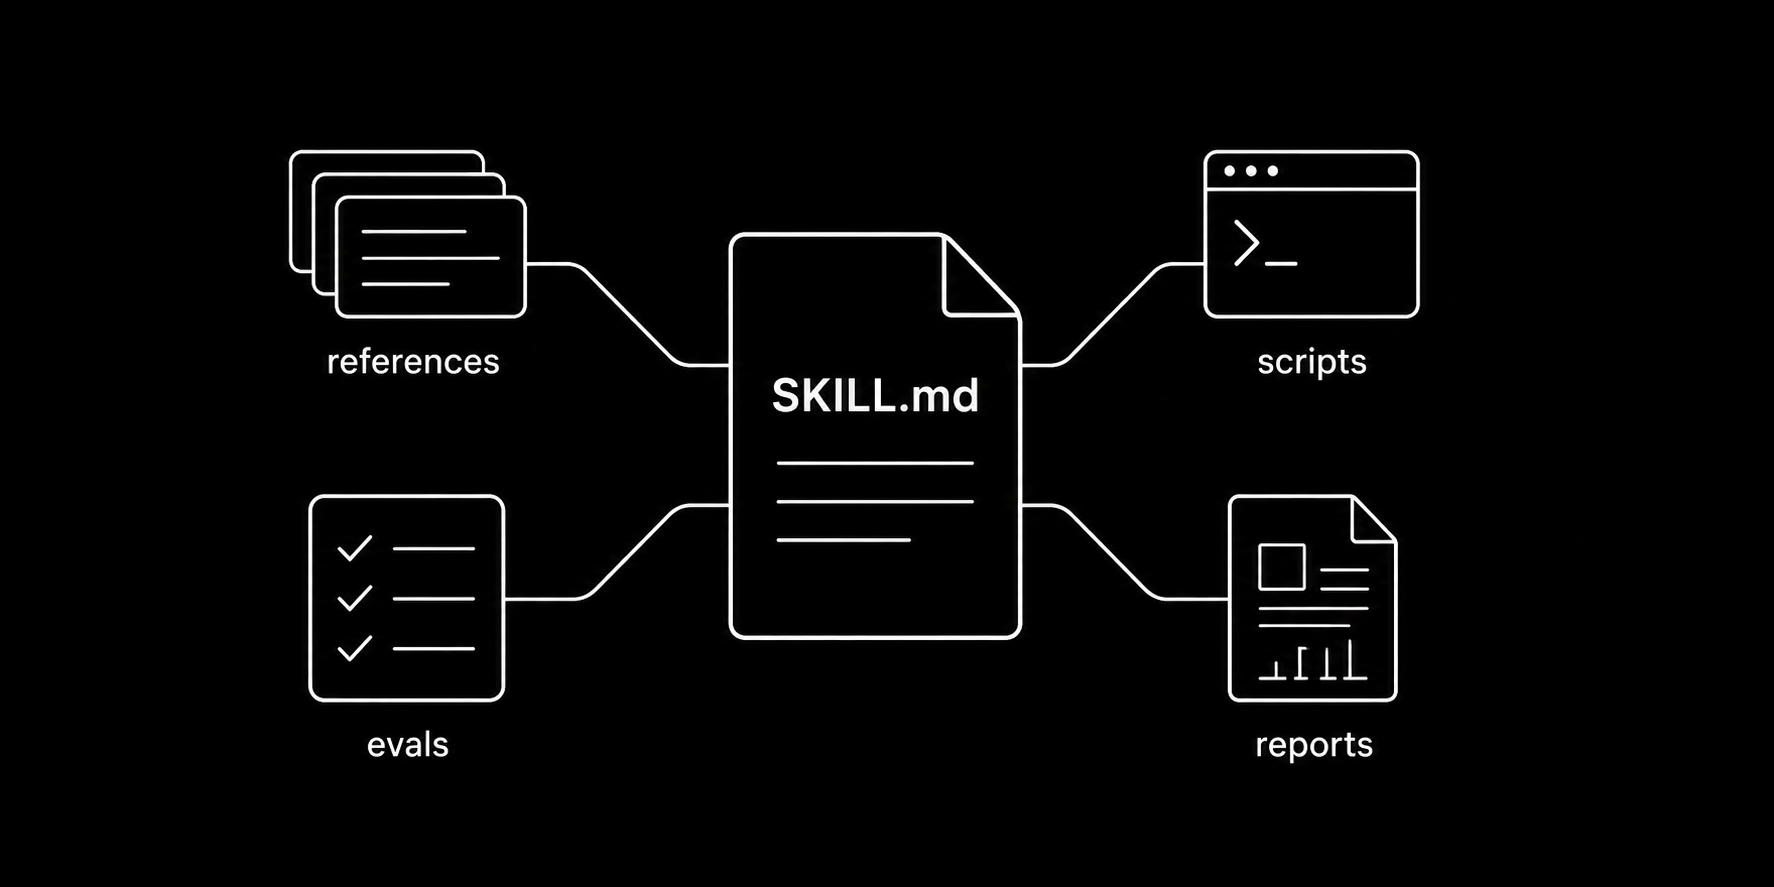
这也是我理解“不要把 skill 写成说明书”的关键。说明书的问题不是它没用,而是它把所有东西都摊在一个平面上。一个成熟 skill 需要的是分层:入口轻、证据足、逻辑稳、边界清楚。
五、第四个认知转变:eval 不是考试,而是防止经验退化
我以前对 eval 的理解偏窄:它就是测试输出质量。
但 yao-meta-skill 里的 eval 更像一套防退化机制。
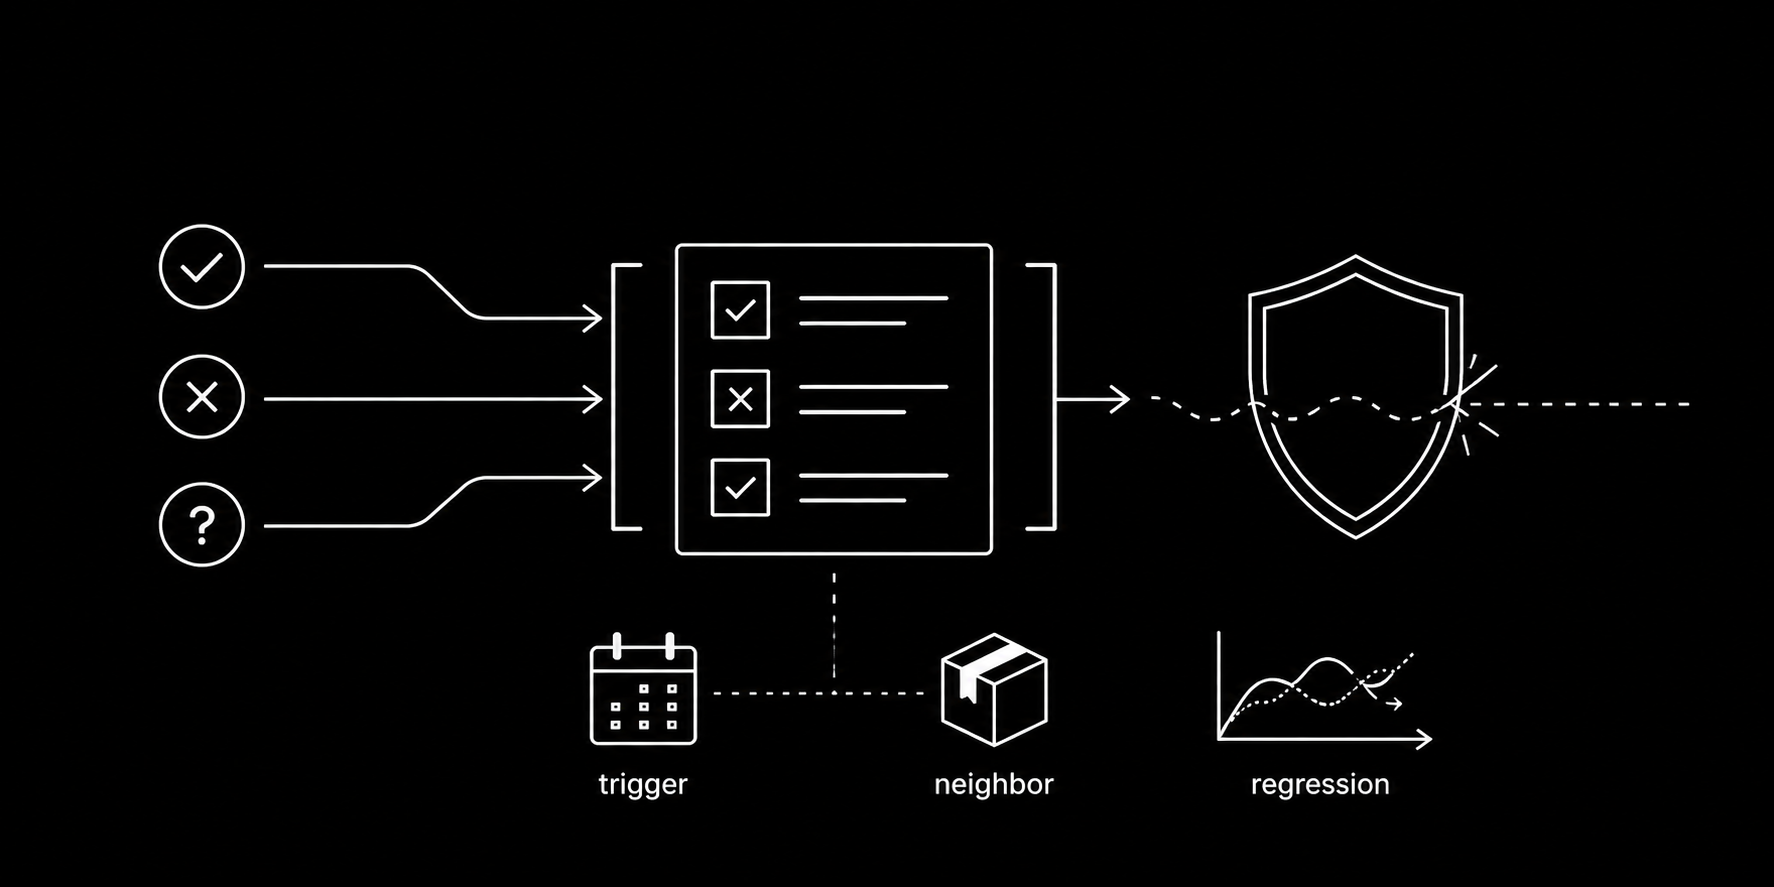
它特别重视 trigger eval。也就是测试这个 skill 在什么情况下应该触发,什么情况下不应该触发,以及哪些“长得很像”的请求其实不该触发。
这通常分成三类:
- should trigger:明确应该触发;
- should not trigger:明确不应该触发;
- near neighbors:相邻但不属于这个 skill 的请求。
第三类尤其关键。
因为真实使用中最容易出问题的,不是离得很远的请求,而是“看起来差不多”的请求。
比如:
- “帮我总结这篇文章”不一定应该触发“创建 skill”的工具;
- “帮我写一个文档”不一定应该触发“把工作流封装成 skill”的工具;
- “我想聊聊这个想法”也不一定应该进入完整工程化流程。
如果没有 near-neighbor eval,skill 很容易变成一个积极过头的助手:什么都想接,什么都想做,最后什么边界都没有。
更高阶的是,yao-meta-skill 还把 eval 分成 train、dev、holdout、blind holdout、adversarial holdout、route confusion、judge-backed blind eval 等层次。
这意味着它关心的不只是“这次生成结果对不对”,而是:
当 skill 继续迭代、description 被修改、references 增加、治理升级之后,它有没有悄悄变得更容易误触发、更难维护,或者更不像原来的能力边界。
这才是 eval 在 skill 工程里的真正价值。
它不是考试。
它是防止经验退化的仪表盘。
六、第五个认知转变:高阶 skill 需要治理,而不是只需要灵感
如果一个 skill 只是个人用的小工具,简单一点完全没问题。
但一旦它开始被团队复用,问题就变了。
谁负责维护?
多久 review 一次?
什么时候算成熟?
什么变化需要重新跑 eval?
如果它不再适合当前工作流,怎么降级或退役?
这些问题在个人 skill 里可以先放轻。但在团队级 skill 里,它们绕不开。
yao-meta-skill 里有 lifecycle、maturity、owner、review cadence、promotion policy、regression history、governance score 等概念。我一开始觉得这些有点“重”,后来才意识到,它们不是为了显得专业,而是为了回答一个很现实的问题:
当一个 skill 不再只是我的个人习惯,而是团队依赖的能力时,它怎么保持可信?
这也是为什么它会强调“rigor grows faster than context cost”。
严谨性要增长,但不能靠无限堆文档来增长。每增加一个 gate、一个报告、一个文件,都应该让 skill 更可靠,而不是只是看起来更完整。
这句话对我很有启发。
很多工程化最后会失败,不是因为不够严谨,而是因为严谨变成了仪式。yao-meta-skill 的方法更像是在提醒:加结构之前,先问它有没有降低真实风险。
七、我最想借鉴的几个实践原则
如果把这次学习压缩成我自己以后写 skill 会遵守的原则,大概是这几条。
第一,先写触发场景,再写操作步骤。
一个 skill 如果不能被正确想起,后面的执行流程再漂亮也没意义。
第二,先定义不做什么,再扩展做什么。
边界越清楚,skill 越稳定。真正高级的复用,不是“什么都能做”,而是“在该做的地方非常可靠”。
第三,SKILL.md 保持瘦身。
入口文件只放路由、骨架和契约。长知识、复杂规则、示例、rubric 和报告都应该移出去。
第四,有重复劳动再加脚本。
不要为了显得工程化而写 scripts。但如果某件事确定、重复、容易出错,就应该让代码接手。
第五,有复用压力再加 eval。
个人探索阶段可以轻一点。团队复用、边界易混淆、质量需要证明时,再系统加入 trigger eval、near neighbor 和回归集。
第六,把 review 结果转成下一轮迭代方向。
不要每次 review 完只留下“感觉还行”。如果一个问题重复出现,就把它变成一个 failure pattern、一个 eval case,或者一条 reference 规则。
第七,永远控制上下文成本。
skill 的价值不是文件越多越好,而是用尽量少的初始上下文,换来尽量稳定的执行质量。
八、它给我的最大启发
我现在会把 yao-meta-skill 看成一种“经验工程化”的方法。
我们过去和 AI 协作,很大程度上靠个人手感:
我知道怎么问。
我知道什么时候该提醒它。
我知道它容易在哪些地方犯错。
我知道什么样的输出才算好。
这些经验当然宝贵。但如果它们永远只停留在个人 commands、零散 skills、聊天记录和 workflow notes 里,它们就很难积累成系统。
yao-meta-skill 提供了一条路径:
把经验提炼成边界;
把边界写进触发描述;
把复杂知识拆进 references;
把确定逻辑沉进 scripts;
把质量要求变成 eval;
把团队复用变成治理;
把一次成功变成可迁移的能力包。
这件事的意义,不只是“我又多了一个 skill”。
如果说内置 skill creator 帮我跨过了“从无到有”的门槛,那么 yao-meta-skill 让我看到的是“从有到稳”的路径。
这两者并不冲突。前者适合快速起草和探索,后者适合把已经证明有价值的工作流继续加固:补边界、补 eval、补治理、补可移植性,直到它不再只是一个好用的小工具,而是一块可以长期复用的能力资产。
它让我开始重新理解 AI 时代的个人工作流沉淀:
以前我们沉淀的是文档、模板和 SOP。
现在我们可以沉淀的是 agent 可以直接调用的能力。
这中间差的不是一段更长的入口文件,而是一套能让经验被触发、被执行、被验证、被维护的结构。
所以,如果你也在用 Codex、Claude,或者已经开始写自己的 commands、agents、skills,我很建议你不要只问:
“我该怎么让 AI 这次回答得更好?”
可以换一个问题:
这次让我满意的经验,能不能被设计成下次自动出现的能力?
这大概就是我学 yao-meta-skill 后最大的收获。
它不是教我写一份更复杂的说明书。
它教我开始把自己的工作经验,当成可以被工程化、评估化、资产化的东西。